エクセル関数で来客数予測|需要予測の計算式を作る方法
この記事ではエクセルの関数を使って、入場者数を予測する計算式の作成方法を紹介します。
商品の販売数の予測(需要予測)にも応用できます。
エクセルで「分析ツール」を使える場合は、
分析ツールを使って回帰分析を行う方法も紹介していますので参考にされてください。
エクセルで来客数を予測する方法(回帰分析で需要予測)
関連記事
エクセル関数を使って来客数を予測する手順(回帰分析)
まずは予測に使うためのデータを準備します。
今回は以下のデータを使用します。
・愛知万博の入場者数(目的変数)
・過去1週間の平日の平均入場者数(説明変数1)
・休日(1=休日、0=平日)(説明変数2)
・日中の雨(1=雨あり、0=雨なし)(説明変数3)
用語の解説
・目的変数:予測したい値(ここでは入場者数)
・説明変数:予測に使う要因・要素
・単回帰分析:説明変数が1つの回帰分析
・重回帰分析:説明変数が2つ以上の回帰分析
エクセルには次のようにデータを入力しておきます。
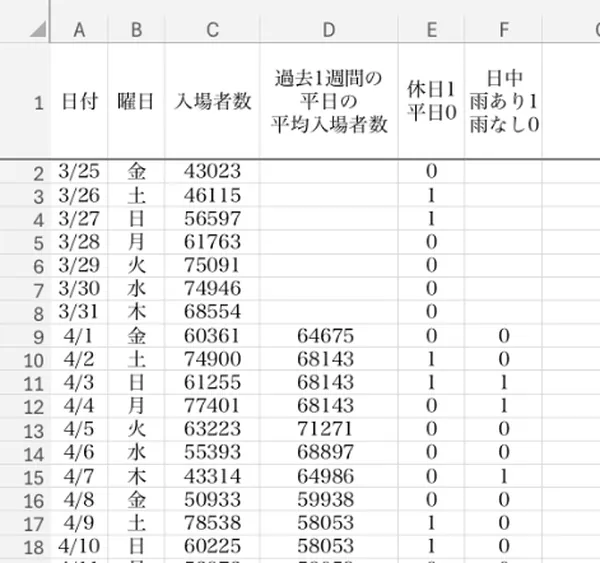
来客数予測の計算式を作る準備(具体例)
データの入っているセルにかからないように、脇の方の空白セルに次のように入力します。
=LINEST(C9:C186, D9:F186, TRUE, TRUE)
LINEST関数の引数について
引数とは、関数に渡すデータのことです。
関数はその名の通り「関」です。
引数が関所(関数)に入って通過すると、別の何かに変わります。
第1引数(「C9:C186」の部分)
目的変数(ここでは入場者数)のデータを選択します。
今回は4/1のデータを起点とします(3月は過去1週間の入場者数のデータがないためです)。
選択するデータの終点はデータ数に応じて変更してください。
第2引数(「D9:F186」の部分)
説明変数のデータをまとめて選択しています。
全ての説明変数のデータが揃っている4/1のデータを起点とします。
第3引数と第4引数にはTRUEと入力します。
LINEST関数に全ての引数を入力すると、次のようなデータが表示されます。
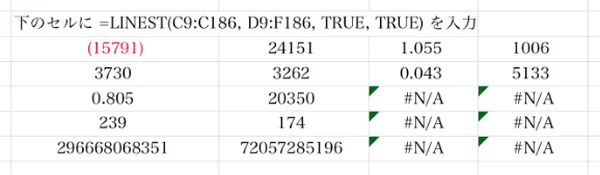
(見やすくなるように表示する桁を調整しています)
LINEST関数の出力結果の見方
LINEST関数を入力して出力された値の意味を解説します。
| 日中の雨 | 休日 | 過去の入場者数 | 切片 |
|---|---|---|---|
| 係数 | 係数 | 係数 | 切片 |
| 標準誤差 | 標準誤差 | 標準誤差 | 標準誤差 |
| R² | Yの標準誤差 | ― | ― |
| F値 | 自由度 | ― | ― |
| 回帰変動 | 残差変動 | ― | ― |
係数(回帰係数)
各説明変数(日中の雨・休日・過去の入場者数)の係数。
目的変数(入場者数)に対してどれくらい影響を与えるかを示します。
・プラスなら入場者数が増える方に影響
・マイナスなら入場者数が減る方に影響
切片
説明変数が全て0のときの基準値
標準誤差
その係数の推定値がどれくらい「ブレやすいか」を表します。
・標準誤差が小さいほどその係数を信頼できます
・係数 / 標準誤差 をt値と呼びます
・「t値の絶対値が2以上」が説明変数に意味があるかを判断する目安とされています
R²(決定係数)
回帰式が実際のデータをどれくらい説明できているかを示します
・1に近いほど精度が高い
・0.7以上ならまずます
Yの標準誤差
実測値と予測のズレの大きさを表します
・小さいほど予測精度が高い
F値
回帰式全体が意味のあるものかどうか検定するための統計量です
・大きいほど良い
自由度
計算に使ったデータの独立した情報量を表す数値です。
・F値やP値を正しく評価するために必要な補助情報
・自由度 = データ数 - 説明変数の数 - 1(切片がある場合)
回帰変動
モデル(回帰式)によって説明できた変動の大きさです。
・大きいほど予測式がデータのばらつきをよく説明できている
残差変動(残差の平方和)
モデルでは説明できなかった誤差の変動です。
・実測値と予測値の差(残差)を2乗して合計したもの
・小さいほどモデルの精度が高いことを意味する
自由度調整済みR²の計算
次に、LINEST関数では表示できない重要なデータを出力する関数について解説します。
データ数
=COUNT(C9:C186)
・予測するために使いたい目的変数のデータ(今回は入場者数)を全て選択してください。
・今回の例では178と出力されます。
自由度調整済みR²
=1-(1-R²)*(データ数-1)/(自由度)
・上の式のR²と自由度には、LINEST関数で出力された値を入力してください。
・今回の場合は0.801と出力されました。1に近いほど良い予測式です。
・R²には説明変数を増やすほど大きくなってしまうという欠点があり、
自由度調整済みR²はその欠点を補正した値です。
(意味のない説明変数が増えると、自由度調整済みR²が小さくなります)
回帰分析による予測式の作り方
これまでの結果から、入場者数を予測する計算式を作成できます。
基本は以下の形になります。
入場者数 = 切片 +(説明変数1 × 係数1)+(説明変数2 × 係数2)+ ・・・
今回の計算結果から得られる予測式は以下の通りです。
入場者数 =
過去1週間の平日の平均入場者数 × 1.055
+ 24151人(休日の場合のみ)
ー 15791人(日中雨の場合のみ)
切片を予測式から省略したことには意味があります。
標準誤差とt値の説明をした際、
「目安として、t値の絶対値が2以上なら、説明変数に意味があると判断できる」
と紹介しました。
3つの説明変数はこの目安をクリアしています。
一方で切片は1006に対して標準誤差が5133と大きすぎるため、t値は2よりかなり小さくなります。
この切片(1006人)には意味がなさそうですので、予測式から省略しました。
この計算式で分かること
・休日は入場者が約2.4万人増える
・雨の日には約1.6万人減る
このように、来店予測の計算式をエクセルで作ることができます。
意味のある説明変数を選ぶために
今回は標準誤差の値から、説明変数に意味があるかどうか判断しました。
この判断を行う際にP値という指標もありますので紹介します。
t値(おさらい)
計算式は 係数 / 標準誤差
変数が意味を持つかの指標
・|t値| > 2 が目安(±どちらでも数字が大きければ意味がある)
・今回「切片」はt値が0.2程度でしたので、意味がないと判断しました。
P値
本当は影響がない(係数=0)と仮定したときに、今回の結果が偶然起きる確率
エクセル関数では、=T.DIST.2T(ABS(t値), 自由度) で計算できます
・係数が有効と判断する目安は0.05以下
(「0.01以下」やそれ以外の場合もあります。0.05は1つの目安です)
・今回「切片」のP値は0.84でした。0.05以上なので予測式から外します。
最新記事と閲覧者数ランキング
閲覧者数ランキング
- 1. ECMWF天気図リンク
- 2. 過去の雷の調べ方
- 3. 気象庁の雷観測記録検索
- 4. 2026年の大雨・大雪